
Aplica OCR a un PDF online y gratis
Convierte PDF escaneados en texto buscable y seleccionable en segundos. El motor admite más de 100 idiomas y mantiene el diseño intacto. Sin registro. Sin marca de agua. Haz tu PDF buscable.
- OCR de PDF gratis. Sin necesidad de cuenta.
- Más de 100 idiomas, diseño conservado y procesamiento por lotes.
- Funciona en Mac, Windows, iPhone y Android en cualquier navegador.

Suelta aquí tu PDF escaneado
Hasta 100 MB por archivo · Gratis para siempre
Los archivos se eliminan en 1 hora. No indexamos el contenido de tus archivos ni lo usamos para entrenar IA.

Archivos eliminados en 1 hora
Cifrado HTTPS en tránsito. Nunca entrenamos IA con el contenido de tus archivos.

Buscable en menos de 2 minutos
La mayoría de los documentos se procesan en segundos. Los escaneos largos se procesan por lotes.

Sin registro, sin marca de agua
Gratis. Sin prueba. Sin registro por correo. Sin límite de páginas.

Diseño conservado
Una capa de texto se superpone a la imagen original. Las columnas, tablas y títulos se quedan donde estaban.
Cómo aplicar OCR a un PDF online
Tres pasos. Sin instalaciones. Sin cuentas. Sin límites ocultos.
Sube tu PDF escaneado
Arrastra el archivo al recuadro de arriba, o haz clic para buscarlo. PDFNoob detecta qué páginas son imágenes.
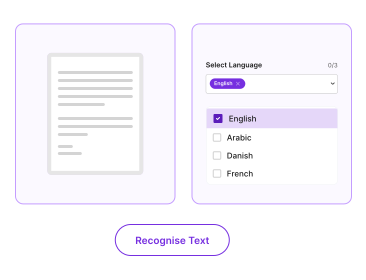
Elige el idioma del documento
Elige el idioma para que el motor de OCR pueda reconocer el texto de las imágenes. La herramienta admite más de 100 idiomas.
Descarga el PDF buscable
Haz clic en OCR. PDFNoob crea una capa de texto invisible sobre las páginas originales. Tu PDF buscable se descarga sin marca de agua.
¿Por qué hacer buscables tus PDF con PDFNoob?
Más de 100 idiomas, diseño conservado y procesamiento por lotes. El flujo de OCR por el que cobran las herramientas de pago.

Más de 100 idiomas
Latino, cirílico, griego, árabe, hebreo, chino (simplificado y tradicional), japonés, coreano, hindi, tamil, tailandés, vietnamita y muchos más.

Salida con el diseño conservado
La capa de texto se sitúa sobre la imagen de la página original. Las columnas, tablas y títulos se quedan donde estaban en el escaneo.

Salida buscable
Cuando el motor termina, puedes usar Cmd/Ctrl+F para encontrar cualquier palabra del PDF. Puedes copiar texto y seleccionar pasajes como en cualquier documento digital.

Procesamiento por lotes
Suelta un escaneo de 200 páginas. PDFNoob ejecuta el reconocimiento de caracteres en cada página en un solo trabajo. Sin hacer clic página por página.

Sin subida a IA
El motor de OCR se ejecuta en nodos de procesamiento aislados. No es un modelo que aprenda de tus datos. Los archivos se eliminan en una hora.

Funciona con fotos de documentos
Las fotos de recibos, contratos o pizarras tomadas con el móvil se procesan igual que los escaneos de superficie plana. Mismo motor. Misma precisión.
Sobre el OCR para PDF
OCR significa reconocimiento óptico de caracteres. La tecnología lee texto a partir de imágenes. La imagen puede ser un escaneo, una foto o una captura de pantalla. Cuando escaneas un contrato en papel en un escáner plano, el PDF resultante guarda cada página como una imagen. El texto de esas páginas son solo píxeles. No puedes buscarlo. No puedes copiarlo. Los lectores de pantalla no pueden leerlo. El OCR procesa la imagen. El motor detecta caracteres. El resultado es una capa de texto que vive de forma invisible sobre la página.
El resultado combina lo mejor de ambos mundos. La página se ve exactamente igual que el escaneo original. Cmd/Ctrl+F ahora encuentra palabras. Puedes resaltar y copiar pasajes. El PDF funciona con herramientas de accesibilidad. PDFNoob usa un motor moderno de clase Tesseract. El motor admite más de 100 idiomas. Maneja diseños de varias columnas, tablas y documentos con varios sistemas de escritura. La capa de texto se alinea con los glifos subyacentes.
OCR PDF frente a PDF a texto: ¿cuál necesito?
Esta es la pregunta que confunde a casi todo el mundo. Si copias texto de un PDF y no obtienes nada, el PDF es solo imagen. Necesitas OCR primero para hacerlo buscable. Si copiar funciona bien pero quieres volcar el texto en un archivo .txt, no necesitas OCR. Usa PDF a texto en su lugar. Una prueba rápida: abre el PDF e intenta seleccionar una palabra con el cursor. Si la palabra se resalta, es texto digital. Si solo puedes dibujar un recuadro de selección, es una imagen. Ese es el terreno del OCR.
Qué afecta a la precisión del OCR
- Calidad del escaneo: Los escaneos de superficie plana a 300 DPI dan los mejores resultados. Por debajo de 200 DPI la precisión cae rápido.
- Iluminación e inclinación: Las fotos necesitan iluminación uniforme y un encuadre más o menos recto para lograr alta precisión.
- Coincidencia de idioma: Elige el idioma correcto del documento. La precisión con francés en modo inglés (o al revés) es mucho menor.
- Fuente y escritura: Las fuentes de imprenta estándar son las más fáciles. La escritura a mano y las tipografías decorativas son las más difíciles.
Herramientas de PDF relacionadas
Otras herramientas que quizá necesites hoy.


Preguntas frecuentes
Preguntas habituales sobre el OCR y cómo hacer buscables los PDF.
¿Qué le hace el OCR a un PDF?
El OCR (reconocimiento óptico de caracteres) lee texto de las imágenes de un PDF escaneado. El motor produce una capa de texto invisible superpuesta a la página. El resultado visual se ve idéntico al escaneo original. Ahora puedes buscar, copiar y seleccionar texto. Los lectores de pantalla pueden leerlo en voz alta.
¿Cómo hago un PDF buscable gratis?
Sube tu PDF escaneado a PDFNoob. Elige el idioma del documento. Haz clic en OCR. Un PDF buscable se descarga en segundos. No hace falta cuenta. El resultado no lleva marca de agua.
¿Cuál es la diferencia entre OCR PDF y PDF a texto?
El OCR es para PDF escaneados o fotos. Son imágenes de texto sin datos de texto reales en el archivo. PDF a texto es para PDF creados digitalmente, donde el texto ya existe y solo hay que extraerlo como una cadena. Si copias texto de un PDF escaneado y no obtienes nada, necesitas OCR primero.
¿Qué idiomas admite el motor de OCR?
Más de 100 idiomas. La lista incluye inglés, español, francés, alemán, italiano, portugués, neerlandés, ruso, polaco, turco, árabe, hebreo, chino (simplificado y tradicional), japonés, coreano, hindi, tamil, tailandés, vietnamita y más. Elige el idioma del documento antes de reconocer el texto para máxima precisión.
¿Es seguro aplicar OCR a un PDF online?
Sí. Los archivos viajan por una conexión HTTPS cifrada. Los eliminamos en menos de una hora. No indexamos el contenido de tus archivos. Nunca los usamos para entrenar IA. El motor se ejecuta en nodos de procesamiento aislados. No hay revisión humana.
¿El OCR cambia la apariencia del PDF?
No. Las imágenes de las páginas originales quedan intactas. El OCR añade una capa de texto invisible encima para que funcionen la búsqueda y la copia. La página sigue viéndose idéntica al escaneo que subiste.
¿El motor detectará caracteres en fotos de documentos?
Sí, con matices. Las fotos de texto nítidas y bien iluminadas funcionan bien. Las fotos borrosas, torcidas o con poca luz dan menor precisión. La herramienta también maneja documentos escaneados de varias páginas y PDF mixtos de fotos o escaneos en un solo lote.
¿El PDF con OCR lleva marca de agua?
Sin marca de agua, nunca. PDFNoob es realmente gratis. Nunca ponemos nuestra marca en tu resultado.