

PDF'e OCR Uygula Çevrimiçi ve Ücretsiz
Taranmış PDF'leri saniyeler içinde aranabilir ve seçilebilir metne dönüştürün. Motor 100'den fazla dili destekler ve düzeni bozmadan korur. Kayıt yok. Filigran yok. PDF'nizi aranabilir yapın.
- Ücretsiz PDF OCR. Hesap gerekmez.
- 100'den fazla dil, düzen korunur, toplu işleme.
- Herhangi bir tarayıcıda Mac, Windows, iPhone ve Android'de çalışır.

Taranmış PDF'nizi buraya bırakın
Dosya başına 100 MB'a kadar · Sonsuza dek ücretsiz
Dosyalar 1 saat içinde silinir. Dosya içeriğinizi dizine eklemez veya yapay zekâ eğitmek için kullanmayız.

Dosyalar 1 Saat İçinde Silinir
Aktarım sırasında HTTPS şifrelemesi. Dosya içeriğinizle asla yapay zekâ eğitmeyiz.

2 Dakikadan Kısa Sürede Aranabilir
Çoğu belge saniyeler içinde işlenir. Uzun taramalar toplu olarak çalışır.

Kayıt Yok, Filigran Yok
Ücretsiz. Deneme yok. E-posta zorunluluğu yok. Sayfa sınırı yok.

Düzen Korunur
Bir metin katmanı orijinal görselin üzerine yerleşir. Sütunlar, tablolar ve başlıklar yerinde kalır.
PDF'e Online Nasıl OCR Uygulanır
Üç adım. Kurulum yok. Hesap yok. Gizli sınır yok.
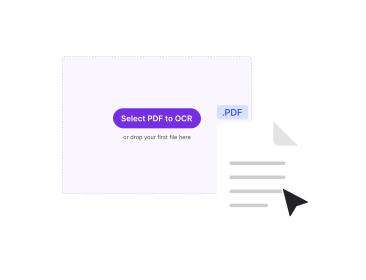
Taranmış PDF'nizi Yükleyin
Dosyayı yukarıdaki kutuya sürükleyin veya göz atmak için tıklayın. PDFNoob hangi sayfaların görsel olduğunu algılar.
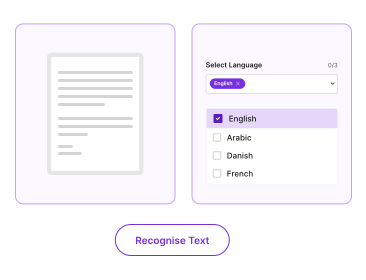
Belge Dilini Seçin
OCR motorunun görsellerdeki metni tanıyabilmesi için dili seçin. Araç 100'den fazla dili destekler.
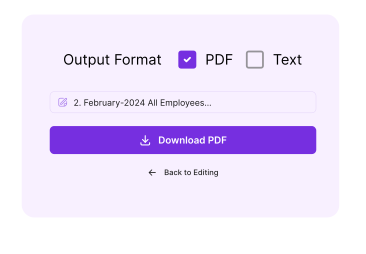
Aranabilir PDF'i İndirin
OCR'a tıklayın. PDFNoob orijinal sayfaların üzerine görünmez bir metin katmanı oluşturur. Aranabilir PDF'niz filigransız iner.
Neden PDFNoob ile PDF'leri Aranabilir Yapmalısınız?
100'den fazla dil, düzen korunur, toplu işleme. Ücretli araçların para aldığı OCR iş akışı.

100'den Fazla Dil
Latin, Kiril, Yunan, Arap, İbrani, Çince (Basitleştirilmiş ve Geleneksel), Japonca, Korece, Hintçe, Tamilce, Tayca, Vietnamca ve daha fazlası.

Düzeni Korunan Çıktı
Metin katmanı orijinal sayfa görselinin üzerine yerleşir. Sütunlar, tablolar ve başlıklar taramadaki yerlerinde kalır.

Aranabilir Çıktı
Motor bittiğinde PDF'teki herhangi bir kelimeyi bulmak için Cmd/Ctrl-F yapabilirsiniz. Herhangi bir dijital belge gibi metni kopyalayabilir ve bölümleri seçebilirsiniz.

Toplu İşleme
200 sayfalık bir tarama bırakın. PDFNoob karakter tanımayı tek işte her sayfada çalıştırır. Sayfa sayfa tıklama yok.

Yapay Zekâya Yükleme Yok
OCR motoru yalıtılmış işleme düğümlerinde çalışır. Verilerinizden öğrenen bir model değildir. Dosyalar bir saat içinde silinir.

Fotoğraf Taramalarında Çalışır
Telefon kamerasıyla çekilen fiş, sözleşme veya beyaz tahta fotoğrafları düz tarayıcı taramalarıyla birlikte işlenir. Aynı motor. Aynı doğruluk.
PDF'ler için OCR Hakkında
OCR, optik karakter tanıma anlamına gelir. Bu teknoloji görsellerden metin okur. Görsel bir tarama, fotoğraf veya ekran görüntüsü olabilir. Kâğıt bir sözleşmeyi düz tarayıcıda taradığınızda, oluşan PDF her sayfayı bir resim olarak saklar. O sayfalardaki metin yalnızca pikseldir. Onu arayamazsınız. Kopyalayamazsınız. Ekran okuyucular okuyamaz. OCR görseli işler. Motor karakterleri algılar. Sonuç, sayfanın üzerinde görünmez biçimde duran bir metin katmanıdır.
Sonuç iki dünyanın da en iyisini birleştirir. Görsel sayfa tam olarak orijinal tarama gibi görünür. Cmd/Ctrl-F artık kelimeleri bulur. Bölümleri vurgulayıp kopyalayabilirsiniz. PDF erişilebilirlik araçlarıyla çalışır. PDFNoob modern, Tesseract sınıfı bir motor kullanır. Motor 100'den fazla dili destekler. Çok sütunlu düzenleri, tabloları ve karışık yazılı belgeleri işler. Metin katmanı alttaki glifler ile hizalanır.
OCR PDF vs. PDF'ten Metne: Hangisine İhtiyacım Var?
Bu, çoğu kişinin takıldığı sorudur. Bir PDF'ten metin kopyalayıp hiçbir şey alamıyorsanız, PDF yalnızca görseldir. Aranabilir yapmak için önce OCR gerekir. Kopyalama sorunsuz çalışıyor ama metni bir .txt dosyasına aktarmak istiyorsanız OCR'a ihtiyacınız yok. Bunun yerine PDF'ten Metne kullanın. Hızlı bir test: PDF'i açın ve imleçle bir kelime seçmeye çalışın. Kelime vurgulanıyorsa dijital metindir. Yalnızca bir seçim kutusu çizebiliyorsanız görseldir. Orası OCR'ın alanıdır.
OCR Doğruluğunu Ne Etkiler
- Tarama kalitesi: 300 DPI düz tarayıcı taramaları en iyi sonucu verir. 200 DPI'ın altında doğruluk hızla düşer.
- Aydınlatma ve eğiklik: Fotoğraf taramaları yüksek doğruluk için eşit aydınlatma ve kabaca düz bir çerçeve gerektirir.
- Dil eşleşmesi: Doğru belge dilini seçin. İngilizce modunda Fransızca (veya tam tersi) için doğruluk çok daha düşüktür.
- Yazı tipi ve yazı: Standart baskı yazı tipleri en kolayıdır. El yazısı ve süslü yazılar en zorudur.
İlgili PDF Araçları
Bugün ihtiyaç duyabileceğiniz diğer araçlar.


Sıkça Sorulan Sorular
OCR ve PDF'leri aranabilir yapma hakkında sık sorulan sorular.
OCR Bir PDF'e Ne Yapar?
OCR (optik karakter tanıma) taranmış bir PDF'teki görsellerden metin okur. Motor, sayfanın üzerine yerleştirilmiş görünmez bir metin katmanı üretir. Görsel çıktı orijinal taramayla aynı görünür. Artık metni arayabilir, kopyalayabilir ve seçebilirsiniz. Ekran okuyucular sesli okuyabilir.
PDF'i Ücretsiz Nasıl Aranabilir Yaparım?
Taranmış PDF'nizi PDFNoob'a yükleyin. Belge dilini seçin. OCR'a tıklayın. Aranabilir bir PDF saniyeler içinde iner. Hesap gerekmez. Çıktıda filigran yoktur.
OCR PDF ile PDF'ten Metne Arasındaki Fark Nedir?
OCR, taranmış PDF'ler veya fotoğraflar içindir. Bunlar dosyada gerçek metin verisi olmayan metin görselleridir. PDF'ten Metne ise metnin zaten var olduğu ve yalnızca dize olarak çıkarılması gereken dijital oluşturulmuş PDF'ler içindir. Taranmış bir PDF'ten metin kopyalayıp hiçbir şey alamıyorsanız önce OCR gerekir.
OCR Motoru Hangi Dilleri Destekler?
100'den fazla dil. Liste İngilizce, İspanyolca, Fransızca, Almanca, İtalyanca, Portekizce, Felemenkçe, Rusça, Lehçe, Türkçe, Arapça, İbranice, Çince (Basitleştirilmiş ve Geleneksel), Japonca, Korece, Hintçe, Tamilce, Tayca, Vietnamca ve daha fazlasını kapsar. En iyi doğruluk için metni tanımadan önce belge dilini seçin.
PDF'e Çevrimiçi OCR Uygulamak Güvenli mi?
Evet. Dosyalar şifreli bir HTTPS bağlantısı üzerinden aktarılır. Bir saat içinde sileriz. Dosya içeriğinizi dizine eklemeyiz. Yapay zekâ eğitmek için asla kullanmayız. Motor yalıtılmış işleme düğümlerinde çalışır. İnsan incelemesi yapılmaz.
OCR PDF'in Görünümünü Değiştirir mi?
Hayır. Orijinal sayfa görselleri bozulmadan kalır. OCR, arama ve kopyalamanın çalışması için üste görünmez bir metin katmanı ekler. Sayfa yüklediğiniz taramayla hâlâ aynı görünür.
Motor Fotoğraf Taramalarında Karakter Algılar mı?
Evet, bazı kayıtlarla. Keskin, iyi aydınlatılmış metin fotoğrafları iyi çalışır. Bulanık, eğik veya az ışıklı fotoğraflar daha düşük doğruluk verir. Araç ayrıca çok sayfalı taranmış belgeleri ve karışık fotoğraf veya tarama PDF'lerini tek bir grupta işler.
OCR Yapılmış PDF'te Filigran Var mı?
Asla filigran yok. PDFNoob gerçekten ücretsizdir. Çıktınıza asla marka koymayız.